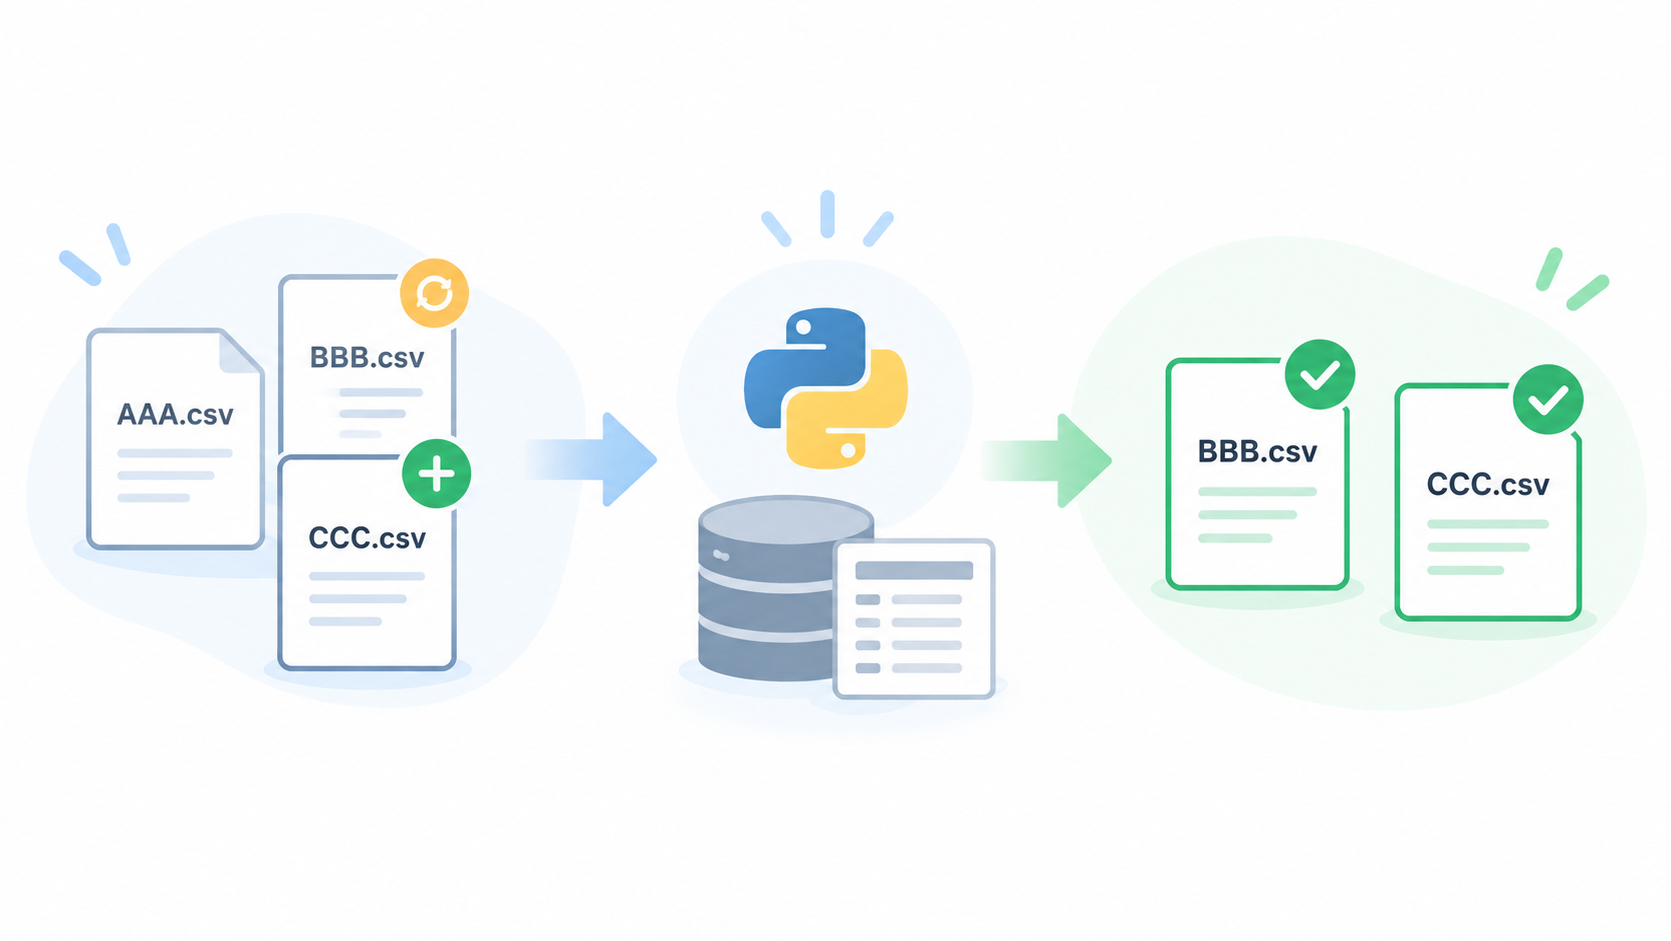
課題
定期的にCSVファイルを取り込む処理では、すでに取り込み済みのファイルまで毎回処理すると、不要な処理が発生します。
実装内容
PythonとSQLiteを使用し、ファイルの最終更新日時とDBに保存された処理履歴を比較して、新規・更新ファイルだけを抽出するロジックを実装しました。
期待できる効果
更新されていないファイルを処理対象から除外でき、不要な再処理を減らせます。
実装の背景
2025年2月に実務で扱ったETL処理の一部を、個人環境で再現したものです。
テスト結果
新規・更新・変更なしの各条件で動作を確認しました。
| ファイル名 | 判定条件 | 実行結果 |
| AAA.csv | 更新なし | 抽出対象外 |
| BBB.csv | 更新あり | 抽出 |
| CCC.csv | DBに履歴なし | 抽出 |
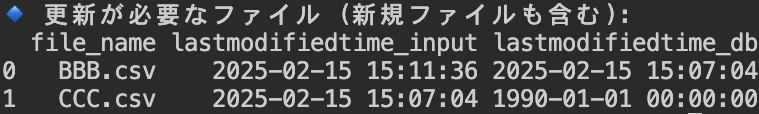
実行結果では、更新されたBBB.csvと新規のCCC.csvのみが抽出され、変更のないAAA.csvは抽出対象から除外されました。
フォルダ構成と処理の全体像
フォルダ構成
以下のフォルダ構成です。
Python/
├── .venv/
├── input/
│   ├── AAA.csv
│   ├── BBB.csv
│   ├── CCC.csv
├── pandas/
│   ├── read_sql.py
└── file_history.db
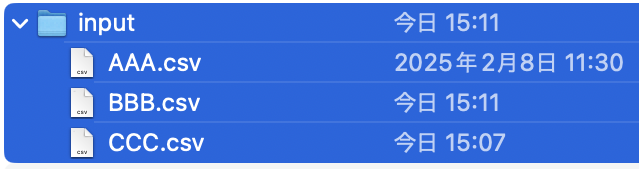
inputフォルダ配下にCSVファイルを作成しました。今日は、2025年2月15日のことです。
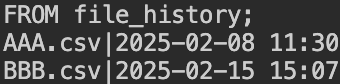
DBはsqliteを使用しました。file_historyテーブルを作成して、AAA.csvとBBB.csvを格納しました。
pandasフォルダ配下のread_sql.pyがプログラムの本体です。
処理の全体像
inputフォルダとDBに格納されているファイル名と最終更新日時を比較して、処理対象ファイルを特定しています。
BBB.csvは、inputの最終更新日時がDBよりも新しい(15:11 > 15:07)ので、取り込み対象です。CCC.csvは、DBに存在しなかったので、DBの最終更新日時をとても古くして(1990-01-01)、取り込み対象にしました。
10個の処理手順
import pandas as pd
import sqlite3
import os
from datetime import timedelta

# 📌 1. SQLite データベースに接続
db_path = "file_history.db"
conn = sqlite3.connect(db_path)
cursor = conn.cursor()

# 📌 2. inputフォルダ内のCSVファイルを取得
input_folder = "input"
csv_files = [f for f in os.listdir(input_folder) if f.endswith(".csv")]

# 📌 3. ファイル名と最終更新日時を取得
file_data = []
for file_name in csv_files:
    file_path = os.path.join(input_folder, file_name)
    last_modified = os.path.getmtime(file_path)  # 最終更新日時
    last_modified_time = pd.to_datetime(last_modified, unit="s") + timedelta(hours=9)
    last_modified_time = last_modified_time.floor('S')  # 秒単位で丸める


    file_data.append({"file_name": file_name, "lastmodifiedtime": last_modified_time})

# 📌 4. Pandasのデータフレーム化(inputフォルダの情報)
df_input_files = pd.DataFrame(file_data)

# 📌 5. SQLiteから登録済みのファイル情報を取得
db_files = []
file_data_db = []

for file_name in csv_files:
    query = "SELECT file_name, lastmodifiedtime FROM file_history WHERE file_name = :FILE_NAME"
    cursor.execute(query, {"FILE_NAME": file_name})
    result = cursor.fetchone()

    if result:
        db_files.append(result[0])  # 取得したファイル名のみリストに追加
        file_data_db.append({"file_name": result[0], "lastmodifiedtime": result[1]})

df_db_exists_file = pd.DataFrame(file_data_db)

# 📌 6. SQLiteに存在しないファイルを取得(新規追加が必要なもの)
df_new_files = df_input_files[~df_input_files["file_name"].isin(df_db_exists_file["file_name"])].copy()

# 📌 7. 新規ファイルの最終更新日時を `1990-01-01 00:00:00` にする
oldest_time = pd.Timestamp("1990-01-01 00:00:00")
df_new_files["lastmodifiedtime"] = oldest_time  # 一番古い日付に設定

# 📌 8. SQLiteに存在するが、最終更新日時が新しいファイルを取得(更新が必要なもの)
df_history_result_files = pd.concat([df_db_exists_file, df_new_files], ignore_index=True)  # DBファイル + 1990年設定の新規ファイル
df_merged_files = df_input_files.merge(df_history_result_files, on="file_name", suffixes=("_input", "_db"))
df_merged_files["lastmodifiedtime_db"] = pd.to_datetime(df_merged_files["lastmodifiedtime_db"])
df_updated_files = df_merged_files[df_merged_files["lastmodifiedtime_input"] > df_merged_files["lastmodifiedtime_db"]]

# 📌 9. 結果の表示
print("🔹 更新が必要なファイル (新規ファイルも含む):")
df_updated_files = df_updated_files.sort_values('file_name').reset_index(drop=True)
print(df_updated_files)

# 📌 10. データベース接続を閉じる
conn.close()
10個の手順があります。
最初に、必要なモジュールを読み込みます。
import pandas as pd
import sqlite3
import os
from datetime import timedelta
手順1は、データベース接続です。
# 📌 1. SQLite データベースに接続
db_path = "file_history.db"
conn = sqlite3.connect(db_path)
cursor = conn.cursor()
手順2は、CSVファイルの取得です。
# 📌 2. inputフォルダ内のCSVファイルを取得
input_folder = "input"
csv_files = [f for f in os.listdir(input_folder) if f.endswith(".csv")]
手順3は、ファイル名と最終更新日時の取得です。
# 📌 3. ファイル名と最終更新日時を取得
file_data = []
for file_name in csv_files:
    file_path = os.path.join(input_folder, file_name)
    last_modified = os.path.getmtime(file_path)  # 最終更新日時
    last_modified_time = pd.to_datetime(last_modified, unit="s") + timedelta(hours=9)
    last_modified_time = last_modified_time.floor('S')  # 秒単位で丸める


    file_data.append({"file_name": file_name, "lastmodifiedtime": last_modified_time})
手順4は、データフレーム化です。
# 📌 4. Pandasのデータフレーム化(inputフォルダの情報)
df_input_files = pd.DataFrame(file_data)
手順5は、DBのファイル情報の取得とデータフレーム化です。
# 📌 5. SQLiteから登録済みのファイル情報を取得
db_files = []
file_data_db = []

for file_name in csv_files:
    query = "SELECT file_name, lastmodifiedtime FROM file_history WHERE file_name = :FILE_NAME"
    cursor.execute(query, {"FILE_NAME": file_name})
    result = cursor.fetchone()

    if result:
        db_files.append(result[0])  # 取得したファイル名のみリストに追加
        file_data_db.append({"file_name": result[0], "lastmodifiedtime": result[1]})

df_db_exists_file = pd.DataFrame(file_data_db)
手順6は、DBに存在しないファイルの明確化です。
# 📌 6. SQLiteに存在しないファイルを取得(新規追加が必要なもの)
df_new_files = df_input_files[~df_input_files["file_name"].isin(df_db_exists_file["file_name"])].copy()
手順7は、DBに存在しないファイルの最終更新日時を最も古いものにする設定です。
# 📌 7. 新規ファイルの最終更新日時を `1990-01-01 00:00:00` にする
oldest_time = pd.Timestamp("1990-01-01 00:00:00")
df_new_files["lastmodifiedtime"] = oldest_time  # 一番古い日付に設定
手順8は、DBに存在しているかつ最終更新日時が新しくなっているファイルの明確化です。
# 📌 8. SQLiteに存在するが、最終更新日時が新しいファイルを取得(更新が必要なもの)
df_history_result_files = pd.concat([df_db_exists_file, df_new_files], ignore_index=True)  # DBファイル + 1990年設定の新規ファイル
df_merged_files = df_input_files.merge(df_history_result_files, on="file_name", suffixes=("_input", "_db"))
df_merged_files["lastmodifiedtime_db"] = pd.to_datetime(df_merged_files["lastmodifiedtime_db"])
df_updated_files = df_merged_files[df_merged_files["lastmodifiedtime_input"] > df_merged_files["lastmodifiedtime_db"]]
手順9は、完全新規ファイル + 更新されているファイルの表示です。
# 📌 9. 結果の表示
print("🔹 更新が必要なファイル (新規ファイルも含む):")
df_updated_files = df_updated_files.sort_values('file_name').reset_index(drop=True)
print(df_updated_files)
手順10は、DB接続を閉じています。
# 📌 10. データベース接続を閉じる
conn.close()
開発補助ツール
ChatGPT
詳細
開発環境、フローチャート、Python処理の詳細、テストについては、2025年2月に書いた以下の記事をご確認ください。